Парсинг данных: когда он нужен, как работает и законно ли это
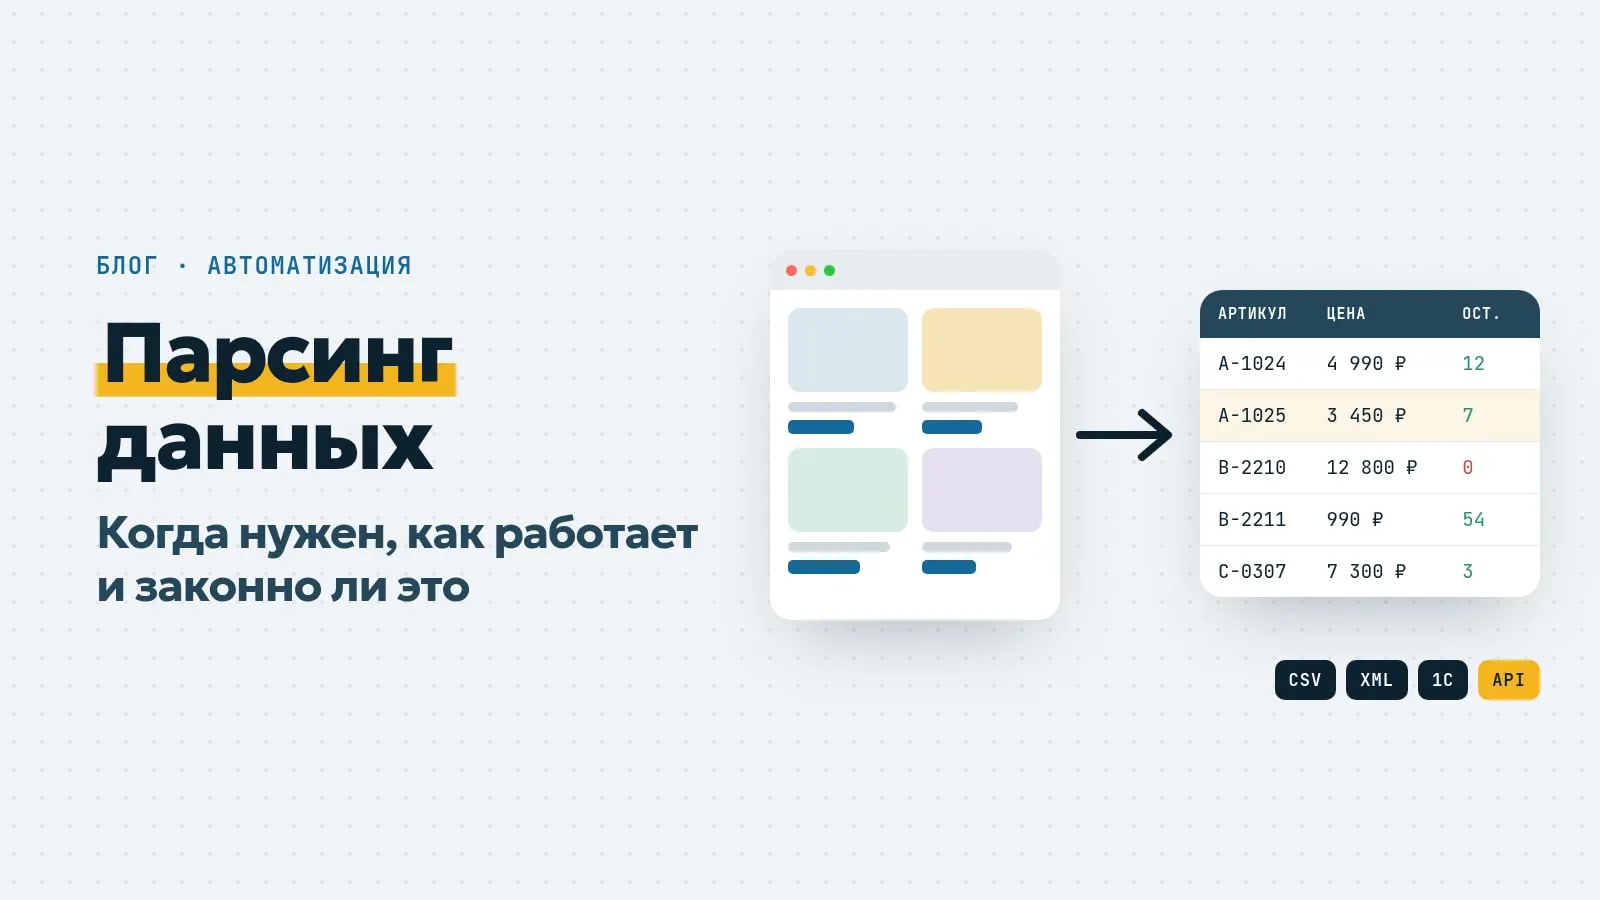
Парсинг — это автоматический сбор данных с сайтов. Программа заходит на нужные страницы, находит на них конкретную информацию — название товара, цену, наличие, характеристики, фото — и складывает её в удобную таблицу или сразу в ваш сайт. То, на что у менеджера ушли бы недели ручного копирования, парсер делает за минуты и повторяет по расписанию.
Когда парсинг действительно нужен
Чаще всего ко мне приходят владельцы интернет-магазинов и сайтов с каталогом. Вот типовые задачи, в которых парсинг экономит больше всего времени и денег.
Наполнить каталог товарами
Поставщик выложил на сайте тысячи позиций с характеристиками и фото, но не даёт удобной выгрузки. Вручную переносить их — месяцы работы. Парсер соберёт товары со всеми полями, разложит по категориям вашего каталога и подготовит к загрузке в CMS.
Держать цены и остатки в актуальном состоянии
Цены и наличие у поставщиков меняются постоянно. Если обновлять их вручную, магазин рано или поздно продаёт то, чего нет на складе, или работает в минус после подорожания. Парсер раз в день или раз в час сверяет данные и обновляет цены и остатки на вашем сайте автоматически.
Следить за ценами конкурентов
Мониторинг показывает, где вы дороже рынка, а где можно поднять цену без потери продаж. Парсер собирает цены конкурентов по вашему списку товаров и присылает сводку: таблицу, отчёт в Excel или уведомление в мессенджер.
Другие задачи
- перенос контента со старого сайта при переезде на новую CMS — собрать свои же страницы, тексты и товары;
- сбор объявлений о недвижимости, авто или оборудовании для аналитики рынка;
- мониторинг тендеров и закупок по ключевым словам;
- сбор и анализ отзывов о товарах, чтобы понять, что нравится и что раздражает покупателей;
- сверка ассортимента: каких товаров нет у вас, но есть у конкурентов.
Как работает парсер
Снаружи всё выглядит просто: на входе ссылки, на выходе таблица. Внутри это цепочка из нескольких шагов.
1. Анализ источника
Сначала я изучаю сайт-источник: как устроены страницы каталога и карточки товара, подгружаются ли данные скриптами, есть ли у сайта открытый API или готовая выгрузка в YML, XML или CSV. Если у поставщика есть официальная выгрузка или API — лучше работать с ними: это надёжнее и законнее парсинга вёрстки.
2. Сбор страниц
Парсер обходит нужные разделы и загружает страницы — так же, как это делает браузер. Для обычных сайтов хватает HTTP-запросов, для сайтов, где содержимое рисуется скриптами, используется «безголовый» браузер. Запросы идут с паузами, чтобы не перегружать чужой сервер.
3. Извлечение данных
Из каждой страницы программа вытаскивает только нужные поля: название, артикул, цену, наличие, характеристики, ссылки на фото. Для этого задаются правила — по каким признакам на странице найти каждое значение.
4. Очистка и сопоставление
Сырые данные почти всегда «грязные»: разные единицы измерения, лишние пробелы, цены с текстом, дубли. Парсер приводит всё к единому виду и сопоставляет чужие товары с вашими — по артикулу, штрихкоду или названию.
5. Выгрузка
Готовые данные выгружаются в нужном формате: CSV, Excel, XML или YML для импорта, файл обмена для 1С — или сразу загружаются в ваш сайт через API CMS.
6. Расписание и контроль
Парсер запускается автоматически по расписанию — например, каждую ночь. Если сайт-источник поменял вёрстку и данные перестали собираться, приходит уведомление, и правила быстро обновляются.
Пишу парсеры на Python: для простых сайтов — запросы и разбор HTML, для сложных — фреймворки для обхода сайтов и управляемый браузер.
Законно ли это
Короткий ответ: сам по себе парсинг не запрещён, но важно, что именно вы собираете и как используете. Ниже — основные правила, на которые я ориентируюсь. Это не юридическая консультация: в спорных случаях лучше уточнить у юриста.
Что обычно можно
- Собирать факты из открытого доступа: цены, наличие, артикулы, технические характеристики. Сообщения о фактах, имеющие исключительно информационный характер, не являются объектами авторского права.
- Работать с данными поставщика с его согласия — по договору, через API или официальную выгрузку. Это самый надёжный вариант.
- Парсить собственный сайт, например при переезде на новую CMS.
Где начинаются риски
- Авторские тексты и фотографии. Описания товаров и фото — объекты авторского права. Собрать их для анализа — одно, а опубликовать у себя без разрешения — уже нарушение, и правообладатель может потребовать компенсацию.
- Базы данных. Гражданский кодекс отдельно защищает права изготовителя базы данных (статьи 1333–1336 ГК РФ). Если база содержит не менее 10 000 элементов, по закону предполагается, что на её создание потрачены существенные средства, и извлекать из неё существенную часть материалов без разрешения нельзя. Скопировать каталог крупного сайта целиком — именно такой риск.
- Персональные данные. Имена, телефоны, почта и профили людей защищены законом № 152-ФЗ. То, что данные лежат в открытом доступе, не даёт права их собирать и использовать: с 2021 года для распространения персональных данных нужно отдельное согласие человека. Самый известный пример — многолетний спор «ВКонтакте» с компанией Double Data о сборе данных из открытых профилей.
- Обход защиты и нагрузка на сайт. Взлом авторизации, обход блокировок и такое количество запросов, которое мешает работе чужого сайта, — это уже не парсинг, а повод для серьёзных претензий.
- Пользовательское соглашение. Многие сайты прямо запрещают автоматический сбор данных в своих правилах — это тоже стоит учитывать.
Как парсить аккуратно
- сначала проверить, нет ли у источника API или официальной выгрузки;
- собирать только нужные поля, а не копировать сайт целиком;
- не собирать персональные данные без законного основания;
- не публиковать чужие тексты и фото без разрешения — переписать описания или договориться с правообладателем;
- делать паузы между запросами и не создавать нагрузку на чужой сервер.
С чего начать
Опишите задачу: откуда нужно собирать данные, какие поля и как часто, куда их загружать. Я проверю источник, предложу самый надёжный способ — API, выгрузку или парсинг — и честно скажу, если в задаче есть юридические риски.
Работа начинается с бесплатного пробного этапа: соберу часть данных с реального источника, и вы увидите результат до оплаты.